Guide, Think, Act: Interactive Embodied Reasoning in Vision-Language-Action Models
Published in European Conference on Computer Vision (ECCV), 2026
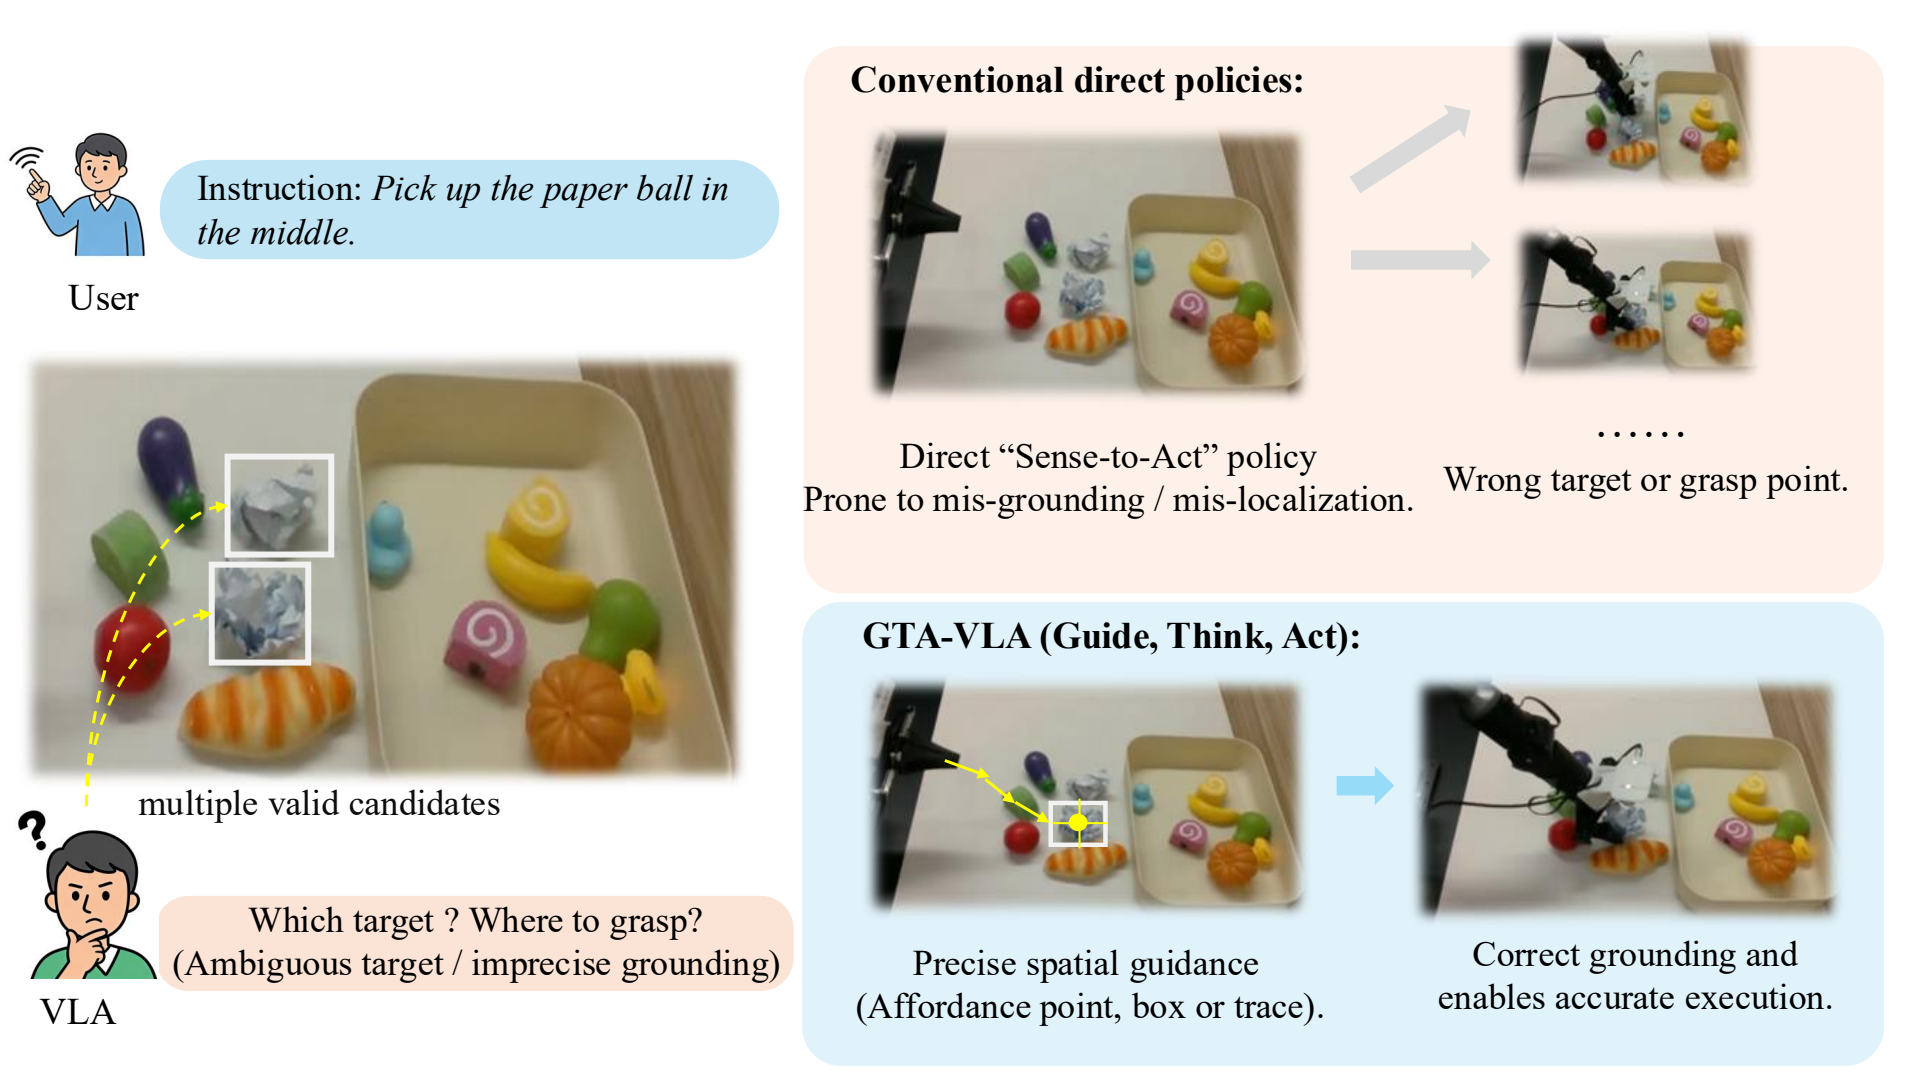
Recommended citation: Yiran Ling*, Qing Lian*, Jinghang Li, Qing Jiang, Tianming Zhang, Xiaoke Jiang, Chuanxiu Liu, Jie Liu, and Lei Zhang. Guide, Think, Act: Interactive Embodied Reasoning in Vision-Language-Action Models. European Conference on Computer Vision (ECCV), 2026. (* Equal contribution.)
Download Paper